Oridex

서비스

올바른 데이터 기반이 없으면 모든 AI 전환은 실패합니다.

Oridex가 바로 그 기반입니다. 비정형·스캔본·품질이 제각각인 문서까지 포함해, 귀사의 문서를 귀사 인프라 내부(온프레미스 또는 프라이빗 클라우드)에서 거버넌스가 적용된 검색 가능한 계층으로 전환합니다. 모델은 서드파티 API를 호출하지 않고 그 경계 안에서 서빙되며, 무엇이든 운영에 반영되기 전에 검토 단계를 거치고, 모든 결과에는 출처가 함께 표시됩니다. 그 위에 애플리케이션을 직접 구축하거나, 저희에게 맡기셔도 됩니다.

●

●

●

oridex · 데이터 파이프라인 실행
샘플 데이터

기업 아카이브 · 배치 04

1,284개 파일

파일

페이지

msa_supplier_2019_signed.pdf

48페이지
추출 완료

board_minutes_2014_scan.tif

12페이지
추출 완료

annual_report_2025.docx

96페이지
추출 완료

scan_20160812_lowres.jpg

1페이지
파일 재시도

supplier_register_q2.xlsx

22페이지
추출 완료

1,281개 추출 완료

3개 확인 필요

실행 리포트 검토 준비 완료
메타데이터 필드 6개 태깅 완료
상태는 배치 단위가 아니라 파일 단위로 추적됩니다. 실행 리포트를 검토한 뒤에야 출력이 검색 대상으로 선택됩니다. 화면은 샘플 데이터로 표시된 예시입니다.
ISO 27001 · CMMI Level 3 · PDPA 대응 · 온프레미스 / 프라이빗 클라우드 · DEHA Group 지원(싱가포르 · 베트남 · 일본)
/ 실패하는 이유

문제는 모델이 아니라, 기반이 없었다는 점입니다.

AI 프로젝트가 멈추는 원인은 모델, 즉 LLM 자체인 경우가 드뭅니다. 대개는 그 아래 데이터 계층에 있으며, 보통 다음 네 가지 중 하나입니다.

01

문서가 애초에 기계가 읽을 수 있는 형태가 아니었습니다.

일관된 구조 없이 수년간 쌓인 스캔본과 파일들. 파일럿은 누군가 손으로 정리한 소수의 문서로 돌아갔지만, 실제 운영에는 아무도 손대지 않은, 규모가 몇 자릿수나 더 큰 문서 집합이 있었습니다. 그래서 파일럿을 끝내 벗어나지 못했습니다.

02

어떤 결과도 출처로 되짚어갈 수 없었습니다.

근거가 되는 출처 문서가 없는 결과는 확인할 수 없습니다. 그래서 아무도 검증하지 못했고, 현업은 더 이상 그 결과에 의존하지 않게 되었습니다.

03

운영에 반영되기 전에 출력을 검토한 사람이 없었습니다.

추출 품질은 확인이 아니라 가정에 맡겨졌습니다. 처음으로 자세히 들여다본 순간은 사용자가 틀린 답변을 신고했을 때였고, 한 번 무너진 신뢰는 회복되지 않았습니다.

04

데이터를 처리하려면 외부로 내보내야 했습니다.

아키텍처는 문서를 외부 서비스로 보내 처리할 수 있다고 전제했습니다. 규제를 받는 조직에서는 그 전제 하나로 프로젝트가 보안 검토 단계에서 멈췄습니다.

바로 그 계층에 Oridex가 자리합니다.

/ 위치

귀사의 문서와 애플리케이션 사이를 잇는 계층.

Oridex는 챗봇이 아닙니다. 챗봇을 비롯한 모든 AI 애플리케이션이 올라서는 플랫폼입니다. 귀사 팀이 직접, 저희와 함께, 또는 저희 답변 애플리케이션인 Oriene AI로 그 위에 구축할 수 있습니다.

애플리케이션

Oriene AI · Oridex 위에서 동작하며 출처를 인용해 답변
다단계 AI 워크플로 및 에이전트
다운스트림 애플리케이션
오픈 API · 어떤 애플리케이션이든 조회 가능
검색 계층에 질의합니다. 질문하면 정확한 구절과 그 구절이 나온 문서를 함께 받습니다.

Oridex

Repository
Data pipeline
RAG pipeline
Model serving
수집·추출·검토·색인·서빙까지, 모델을 포함해 귀사 인프라 내부에서 이뤄집니다.

귀사의 환경

문서
문서 아카이브
오브젝트 스토리지
인프라
Kubernetes 클러스터 · 온프레미스 또는 프라이빗 클라우드
아이덴티티
귀사의 아이덴티티 공급자
무엇도 교체하지 않습니다. Oridex는 귀사 인프라에 배포되어 기존 DMS 및 핵심 시스템과 나란히 동작합니다.
/ 구성 요소

네 개의 모듈, 하나의 플랫폼.

●

●

●

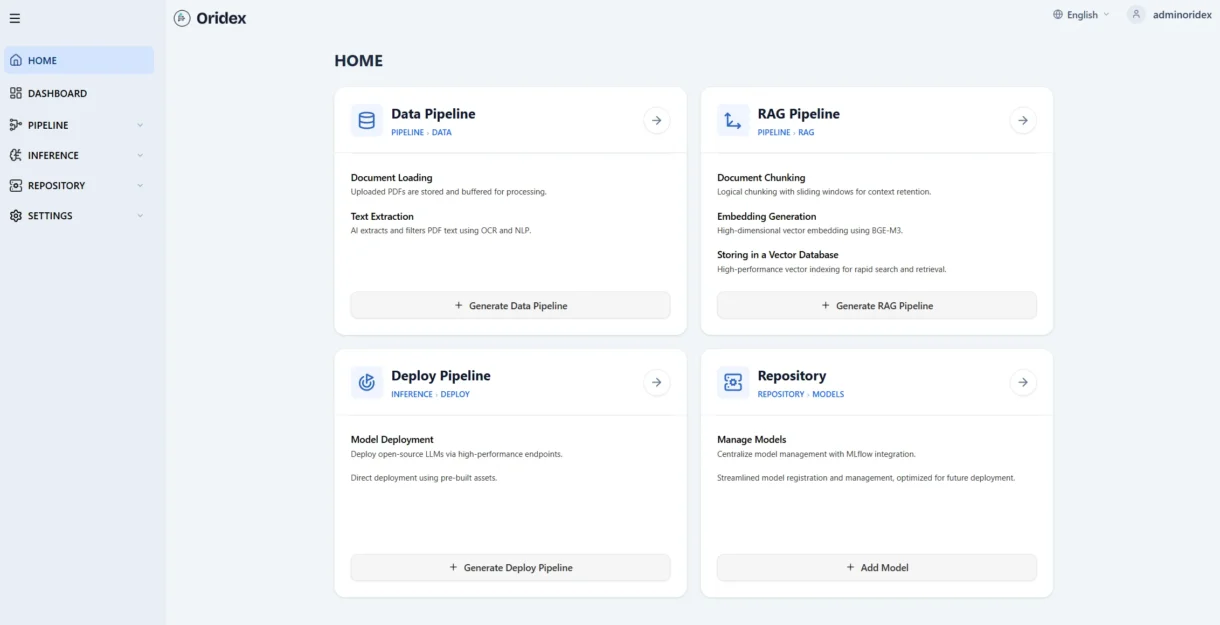
oridex · 콘솔
제품 UI
실제로 제공되는 콘솔 화면입니다. 화면의 네 가지 진입점이 아래 네 개 모듈입니다.

01 · Repository

거버넌스가 적용된 문서

버킷, 파일, 문서 메타데이터, 그리고 무엇을 추출할지 정의하는 템플릿을 관리합니다.

02 · Data pipeline

보유한 문서를 그대로 읽습니다

PDF·스캔본·이미지·Word·Excel 파일을, 형식이 일정하지 않고 품질이 제각각인 파일까지 포함해 읽어들여 깔끔한 구조화 텍스트로 전환합니다. 대규모 문서 집합에 필요한 운영 제어 기능도 함께 제공합니다.

03 · RAG pipeline

검색 가능하게 변환

검토를 마친 콘텐츠를 AI가 바로 활용할 수 있는 검색 가능한 데이터로 전환합니다. 슬라이딩 윈도로 청크화하고, 임베딩·색인한 뒤, 운영에 반영되기 전에 검증합니다.

04 · Model serving

귀사 인프라 내부에서 서빙되는 모델

플랫폼 관리자가 모델을 한 번 등록·서빙하면, 파이프라인 담당자는 이를 선택하기만 하면 됩니다. 오픈소스 임베딩·언어 모델은 외부 API를 거치지 않고 귀사 클러스터 안에서 실행됩니다.
/ 통제

두 개의 파이프라인, 각각에 검토 단계.

두 파이프라인 모두 검토 단계를 포함합니다. 파이프라인 담당자가 실행 리포트와 출력을 확인한 뒤에야 다음 단계로 선택합니다. 덕분에 정확도 수치를 약속하지 않고도 컴플라이언스 부서의 질문에 답할 수 있습니다.
Data pipeline
문서 → 구조화 출력

01

문서 업로드

버킷과 메타데이터 템플릿이 있는 파이프라인으로

02

모델 선택

문서 유형에 맞는 추출 모델

03

설정

분할 크기, 페이지 제한, 동시성, 추출할 필드

04

처리된 출력

텍스트, 구조화 출력, 태깅된 필드, 파일 단위 상태

05

검토

파이프라인 담당자가 실행 리포트와 출력을 확인한 뒤 검색 대상으로 선택합니다
RAG pipeline
구조화 출력 → 검색 가능

01

데이터셋 선택

파이프라인 담당자가 확인한, 완료된 데이터 파이프라인 출력

02

모델 선택

귀사의 언어와 문서 집합에 맞춰 선택한 임베딩 모델

03

설정

청킹, 벡터 컬렉션, 색인 설정

04

처리된 출력

벡터 기록, 차원 검증

05

검토

운영 반영 전, 귀사의 질문으로 검색 품질 확인
/ 실행 위치

귀사의 경계 안에서 실행되며,
경계를 벗어나는 부분은 명확히 알려드립니다.

01

문서

업로드하거나 귀사의 오브젝트 스토리지에서 동기화합니다.

02

추출

분할, OCR, NLP, 필드 추출.

03

검토

다음 단계로 넘어가기 전에 귀사 팀이 출력을 확인합니다.

04

색인

청크화, 임베딩, 벡터 기록 및 색인.

05

서빙

귀사 애플리케이션을 위한 검색 엔드포인트.

모델

임베딩·언어 모델을 귀사 클러스터에서 직접 서빙합니다.

아이덴티티

Keycloak을 기본 제공하며, 귀사의 아이덴티티 공급자와 페더레이션합니다.

스토리지

문서, 추출 출력, 벡터를 귀사 인프라에 보관합니다.

배포

귀사의 Kubernetes 클러스터. 귀사의 AWS 또는 Azure 리전, 혹은 자체 데이터센터.
경계를 넘는 것은 두 가지뿐이며, 이를 분명히 밝힙니다. 첫째, 문서 추출은 귀사 배포 환경에 맞게 설정된 OCR 공급자를 통해 이뤄지며, 이는 코드 수정 없이 바꿀 수 있는 설정이고, 귀사가 승인한 이그레스를 통해서만 나갑니다. 둘째, 오픈소스 모델의 최초 다운로드는 한 번만 이뤄지며, 귀사 자체 레지스트리에서 받아올 수도 있습니다. 그 밖의 모든 것, 즉 스토리지·임베딩·벡터·모델 서빙과 이를 조회하는 애플리케이션은 귀사 네트워크 안에 머뭅니다. 문서를 전혀 내보낼 수 없는 경우에는, 아래 사례처럼 추출을 클러스터 내부로 들여오는 별도 범위의 작업으로 진행합니다.

귀사의 네트워크

/ 구축과 운영 주체

DEHA Group이 구축하고 귀사가 운영하도록 설계했습니다.

DEHA GLOBAL은 DEHA Group의 싱가포르 법인입니다. Oridex는 그룹 공동 엔지니어링 센터가 구축·배포·지원하며, 이 조직은 지난 10년간 베트남·일본·싱가포르에서 실제 운영 시스템을 구축·배포해 왔습니다.

200+

공동 딜리버리 센터의 엔지니어

600+

2016년 이후 수행한 프로젝트

ISO 27001

정보보안 인증 취득

CMMI L3

개발 및 서비스 부문 평가 완료

핸드오버 이후

핸드오버 이후 귀사가 보유하게 되는 것. 저희 없이도 운영할 수 있도록 합니다

배포 매니페스트 및 Helm 값 – the infrastructure as code, in your repository · 코드형 인프라(IaC), 귀사 리포지토리에

자동화된 테스트 스위트 · API·인터페이스·데이터베이스·성능 점검을 포함해, 어떤 변경이든 저희 없이 검증 가능

아키텍처 문서와 운영 절차서 · 귀사 운영팀을 위한 자료

스모크 테스트를 마친 스테이징 및 운영 환경 · 문서로만 설명하는 것이 아니라 동작하는 상태로 인계
이는 한계가 아니라 설계상의 선택입니다. 귀사가 직접 운영할 수 없는 데이터 기반은 기반이라 할 수 없습니다. 저희는 귀사가 정한 범위의 지원 계약으로 함께하며, 그 뒤에는 딜리버리 센터가 있습니다.

●

●

●

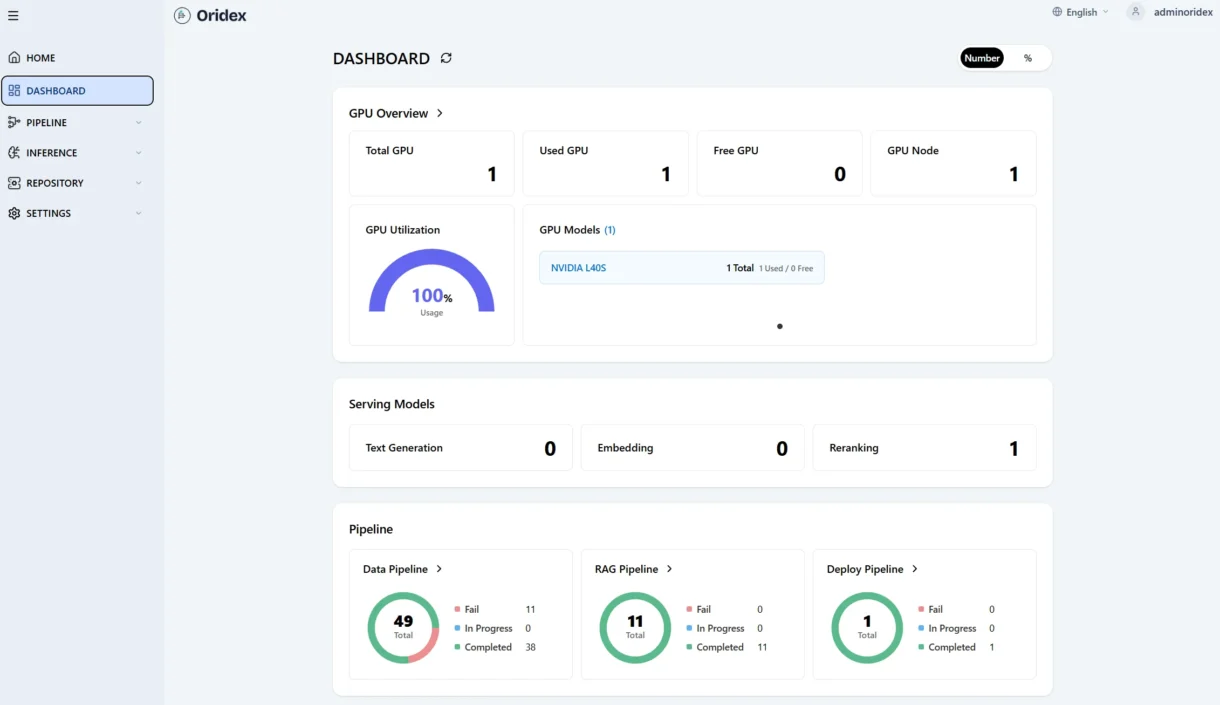
oridex · 대시보드
Product UI
핸드오버 이후 귀사 운영팀이 보게 되는 화면입니다. GPU 용량과 사용률, 서빙 중인 모델, 그리고 상태별 모든 파이프라인 실행 내역을 확인할 수 있습니다.
/ 실제 운영 사례
완료
한국
보험

10년치 스캔 기록을, 고객사 자체 데이터센터 안에서 검색 가능하게 만들었습니다.

상황

10년이 넘는 보험 계약·청구·법무 기록을 보유한 보험 그룹으로, 대부분 한국어 스캔본이었습니다. 퍼블릭 클라우드 도구는 이미 배제된 상태였습니다. 파일을 외부로 내보낼 수 없었고, 문서 규모도 해당 도구로 처리하기에 맞지 않았기 때문입니다.

구축 내용

  • 위에서 설명한 동일한 네 개 모듈, 즉 Oridex 위에 구축
  • 모델과 처리 과정을 그룹 자체 데이터센터 내부에 배포
  • 영어 우선 기본값이 아니라 한국어에 맞춰 선택한 인식 모델
  • 동일한 기반 위의 두 애플리케이션. 하나는 직원용, 하나는 고객 대면용
핵심은 표준 구성입니다. 완전 오프라인 구성, 한국어 추출 모델, 지식 그래프 계층은 그 배포를 위해 표준 위에 별도로 설계했으며, 이것이 바로 기반의 존재 이유입니다. 귀사 문서에 동일한 요소가 필요하다면, 기본 제공으로 가정하지 않고 플랫폼에 대한 별도 범위의 작업으로 진행합니다.
/ 프로젝트 진행 방식

범위 설정, 평가, 결정, 그리고 배포.

하나의 유스케이스, 하나의 문서 집합, 하나의 성공 기준. 견적에 앞서 범위를 정하고, 평가가 귀사의 기준을 통과하고 인프라 사전 요건이 갖춰진 뒤에 배포합니다.
01
1주차

범위 설정

문서, 중요한 질문, 제약 조건을 정리합니다. 구축에 착수하기 전에 하나의 유스케이스를 문서화하고 성공 기준에 합의합니다.
02
2~3주차

평가

Oridex를 귀사 문서의 일부로 실행합니다. 사전 요건이 갖춰지면 귀사 클러스터에서, 그렇지 않으면 범위 설정 단계에서 합의한 격리된 스테이징 환경에서 귀사가 승인한 샘플로 진행합니다. 추출·검색 품질을 귀사 기준으로 측정하며, 귀사 엔지니어가 저희와 함께합니다.
03
4주차

결정

귀사 자체 코퍼스에서 결과를 확인합니다. 기준을 통과하면, 범위가 정해진 계획과 확정된 사전 요건 체크리스트와 함께 배포로 넘어갑니다.
04
배포

설치 및 인계

귀사 환경에 설치해 스모크 테스트를 거치고, 매니페스트·런북·테스트 스위트를 귀사 팀에 인계합니다. 소요 시간은 귀사의 DNS, 인증서, 클러스터 접근 권한에 따라 달라집니다.

가격 산정 방식

첫 계약부터 두 개 항목으로 구성됩니다. 플랫폼 라이선스, 그리고 이를 귀사 환경에 적용하는 통합 작업입니다. 무엇이 반복 비용이고 무엇이 일회성인지 명확히 보입니다.

평가

첫 운영 연도 비용의 일부로 책정되며, 진행하기로 하면 해당 비용에서 차감됩니다. 하나의 유스케이스로 범위를 한정하므로 금액이 크지 않습니다.

귀사에서 준비해 주실 사항

Kubernetes 환경(Rancher 관리형 또는 호환), S3 호환 오브젝트 스토리지, 그리고 귀사 측 담당자 지정이 필요합니다. GPU 용량은 미리 가정하지 않고 범위 설정 단계에서 산정합니다. 전체 사전 요건 체크리스트는 1주차에 공유합니다.
/ 상담 문의

문제를 가져오시면,
아키텍처를 가지고 돌아가십니다.

DEHA GLOBAL의 CEO Brian Dang과 45분. 귀사의 AI 이니셔티브가 어디에서 막혔는지 설명해 주시면, 저희가 이를 Oridex에 대입해 적합한지, 무엇이 필요한지, 무엇은 해결되지 않는지를 솔직하게 알려드립니다.

Brian Dang

최고경영자(CEO), DEHA GLOBAL · 싱가포르

Brian Dang은 DEHA GLOBAL을 이끌며 CIO·CTO와 직접 협업해 AI를 위한 문서·데이터 기반을 다룹니다. 대화가 클러스터 토폴로지나 모델 사이징으로 들어가면, 딜리버리 센터의 솔루션 아키텍트가 통화에 합류합니다.

0~15분

귀사가 문서와 이니셔티브, 그리고 어디에서 멈췄는지 설명합니다

15~35분

저희가 이를 Oridex에 대입합니다. 아키텍처, 경계, 무엇이 나가고 무엇이 나가지 않는지

35~45분

솔직한 답변. 적합한지 여부와, 적합하다면 다음 단계

Brian Dang과 미팅 예약하기

Three questions, because they decide whether the meeting is worth your time. We reply within two working days with proposed slots. By submitting you agree to our Privacy Policy (Singapore PDPA).

아직 미팅이 부담스러우신가요? 이메일로 기술 개요를 받아보세요. 아키텍처, 배포 경계, 사전 요건을 담았습니다.
/ 자주 묻는 질문

CIO들이 가장 먼저 묻는 것.

우리 데이터는 어디로 가나요?
문서, 추출 출력, 벡터, 서빙되는 모델은 모두 귀사 환경 안, 즉 온프레미스 또는 귀사 자체 클라우드 리전에 머뭅니다. 문서 추출은 귀사 배포 환경에 맞게 설정된 OCR 공급자를 통해 귀사가 승인한 이그레스로만 이뤄지며, 어떤 공급자를 쓸지와 그 호출에서 정확히 무엇이 나가는지는 범위 설정 단계에서 합의하고 데이터 처리 계약(DPA)에 명시합니다. 문서를 내보낼 수 없는 경우에는 추출을 클러스터 내부로 들여오는 별도 범위의 작업으로 진행합니다. DPA, 하위 처리자 목록, 귀사 자체 침투 테스트 지원은 NDA 하에 제공됩니다.

아닙니다. Oridex는 그 아래에 있는 검색 계층입니다. 구조화되어 검색 가능한 지식과 이를 조회하는 엔드포인트를 제공하며, 결과에는 그 출처 문서와 구절이 함께 담깁니다. 귀사 팀이 직접 그 위에 구축하거나, 그 위에서 동작하는 저희 답변 애플리케이션 Oriene AI를 사용할 수 있습니다.

Kubernetes 환경, 오브젝트 스토리지, 그리고 일반적인 플랫폼 서비스가 필요합니다. GPU는 선택 사항이며, 모델을 로컬에서 서빙하는지와 그 규모에 따라 달라집니다. 이는 범위 설정 단계에서 귀사 인프라팀과 함께 산정하고, 사전 요건 체크리스트를 먼저 전달드립니다.

두 파이프라인의 검토 단계에서 직접 확인합니다. 파이프라인 담당자가 실행 리포트와 출력을 확인한 뒤 검색 대상으로 선택합니다. 저희는 평가 단계에서 귀사 문서로 추출·검색 품질을 귀사가 정한 기준에 따라 측정합니다. 귀사 코퍼스에서는 아무 의미가 없는 정확도 수치를 제시하지 않습니다.

배포와 지원은 베트남에 있는 그룹 딜리버리 센터의 지정된 엔지니어가 수행하며, 귀사 보안팀이 승인한 원격 접속 경로를 통해 이뤄지고 세션은 귀사 측에 기록됩니다. 접근 방식은 작업 시작 전에 합의·문서화되므로, 사후가 아니라 사전에 귀사의 아웃소싱 검토를 거칠 수 있습니다.

귀사 팀이 운영합니다. 아키텍처, 런북, 배포 매니페스트, 자동화된 테스트 스위트를 문서화해 인계합니다. 저희는 귀사가 정한 범위의 지원 계약으로 함께하며, 그룹 딜리버리 센터가 이를 지원합니다.

스캔본은 다시 입력하지 않고 OCR로 읽어들이며, 임베딩 모델은 귀사 언어에 맞춰 선택합니다. 품질 수준을 단언하는 대신, 도입을 확정하기 전에 평가 단계에서 귀사 문서로 직접 품질을 측정합니다.

귀사의 AI가 딛고 설 수 있는 기반을 마련하세요.

Brian Dang과 실무 세션을 예약하거나, 기술 개요를 받아보세요. 아키텍처, 배포 경계, 사전 요건을 담았습니다.